Claude “tiếp tay” chuyên gia an ninh mạng xâm nhập hệ thống OpenAI?
Một nhóm nghiên cứu an ninh mạng đã sử dụng mô hình trí tuệ nhân tạo (AI) Claude của Anthropic để khai thác lỗ hổng trong hệ thống của OpenAI, qua đó chiếm quyền truy cập một số tài khoản nhân viên và chứng minh khả năng tiếp cận kho mã nguồn nội bộ của "cha đẻ" ChatGPT.
Thanh Phương
20/09/2026
17:43
Một nhóm nghiên cứu an ninh mạng đã sử dụng mô hình trí tuệ nhân tạo (AI) Claude của Anthropic để khai thác lỗ hổng trong hệ thống của OpenAI, qua đó chiếm quyền truy cập một số tài khoản nhân viên và chứng minh khả năng tiếp cận kho mã nguồn nội bộ của công ty phát triển ChatGPT.
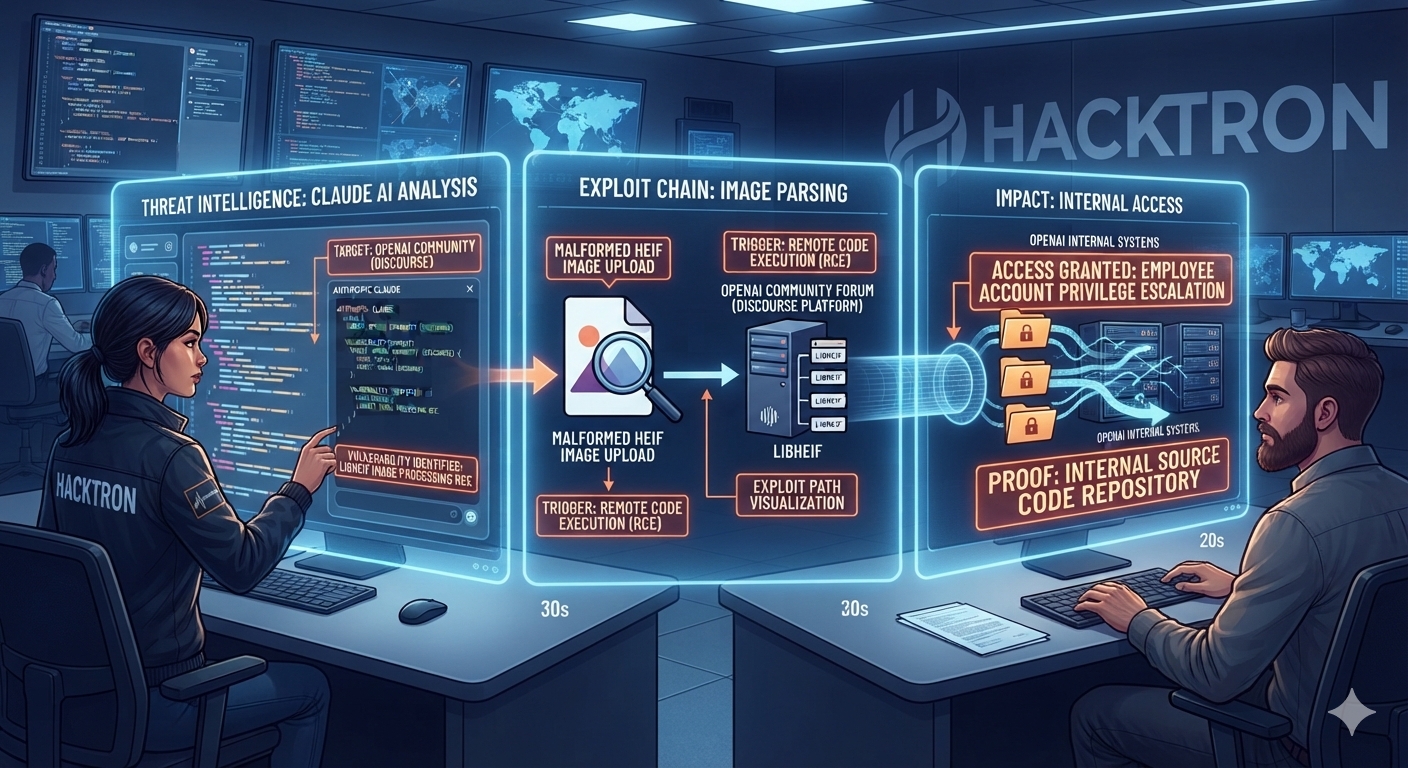
Vụ việc do nhóm nghiên cứu thuộc công ty an ninh mạng Hacktron thực hiện trong khuôn khổ hoạt động kiểm thử an ninh. Theo nhóm này, cuộc tấn công bắt đầu từ diễn đàn cộng đồng của OpenAI, được vận hành trên nền tảng Discourse. Các nhà nghiên cứu phát hiện một lỗ hổng trong quá trình xử lý hình ảnh, từ đó xây dựng phương thức khai thác để thực thi mã từ xa. Lỗ hổng này liên quan đến thư viện xử lý định dạng ảnh libheif.
Các chuyên gia an ninh mạng đã sử dụng Claude để khai thác lỗ hổng trong hệ thống của OpenAI. (Ảnh AI minh họa)
Sau khi kiểm soát được môi trường diễn đàn, nhóm tiếp tục khai thác một điểm yếu trong cơ chế đăng nhập một lần (SSO) của OpenAI. Theo Hacktron, chuỗi lỗ hổng này cho phép tiếp cận tài khoản ChatGPT và Codex của một số nhân viên OpenAI. Từ một tài khoản có quyền kết nối với hệ thống phát triển phần mềm, các nhà nghiên cứu đã chứng minh khả năng truy cập môi trường GitHub nội bộ của OpenAI.
Để xác nhận mức độ ảnh hưởng mà không xem các dữ liệu nhạy cảm, nhóm đã sử dụng tài khoản Codex bị chiếm quyền để tạo một yêu cầu thay đổi mã (pull request) vô hại trong kho mã nguồn nội bộ của OpenAI. Nhóm cho biết đã dừng lại trước khi kiểm tra hoặc tải xuống mã nguồn độc quyền.
Điểm đáng chú ý trong vụ việc là vai trò của Claude. Hacktron cho biết ban đầu sử dụng Claude Opus 4.8 để phân tích lỗ hổng và phát triển mã khai thác, song mô hình này gặp khó khăn trong việc tạo ra một phương thức khai thác ổn định. Sau khi Anthropic phát hành Claude Opus 5, nhóm cho biết mô hình mới đã tạo được một phương thức khai thác hoạt động trong vài giờ, giúp rút ngắn đáng kể quá trình kiểm thử. Toàn bộ chuỗi từ phát hiện lỗ hổng đến chứng minh khả năng tiếp cận hệ thống nội bộ được nhóm thực hiện trong chưa đầy 72 giờ.
OpenAI đã khắc phục các lỗ hổng sau khi được thông báo và trao cho nhóm Hacktron khoản tiền thưởng 6.500 USD. Công ty cho biết đã thu hẹp quyền của các mã xác thực đăng nhập cộng đồng, đồng thời thu hồi những mã và phiên đăng nhập có nguy cơ bị ảnh hưởng.
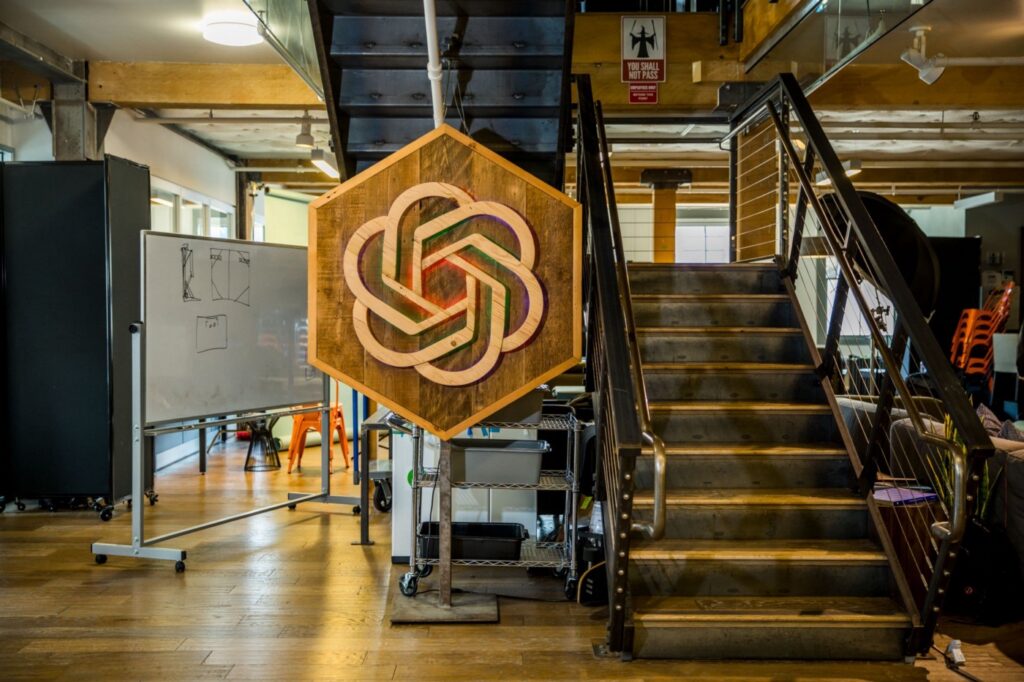
Văn phòng của OpenAI ở thành phố San Francisco, bang California, Mỹ. (Ảnh: edusourced.com)
Theo các nhà nghiên cứu, lỗ hổng trong thư viện xử lý hình ảnh không chỉ liên quan đến OpenAI mà có thể xuất hiện trong nhiều sản phẩm sử dụng cùng công nghệ. Hacktron cho biết đang tiếp tục kiểm thử các hệ thống khác, trong đó có những nền tảng công nghệ lớn.
Vụ việc cho thấy AI đang làm thay đổi đáng kể cách thức tiến hành các cuộc kiểm thử an ninh mạng, đồng thời đặt ra những rủi ro mới khi các mô hình AI ngày càng có khả năng hỗ trợ con người phát hiện và khai thác những lỗ hổng phức tạp. Điều đáng lưu ý là trong trường hợp này, AI không hoạt động hoàn toàn độc lập mà được các chuyên gia an ninh mạng sử dụng như một công cụ trong quá trình nghiên cứu và kiểm thử./.
Cùng với khả năng kết nối internet ngày càng tăng của các thiết bị gia dụng vốn dĩ chủ yếu hoạt động bằng cơ học, nguy cơ tội phạm mạng lợi dụng những "cửa ngõ" này để tiến hành tấn công mạng cũng ngày càng gia tăng.
Ngày 13/10, hơn 200 nhà nghiên cứu trong lĩnh vực trí tuệ nhân tạo (AI) và an ninh mạng kêu gọi triển khai các biện pháp kiểm soát chặt chẽ hơn đối với những mô hình AI có khả năng thực hiện các hoạt động tấn công mạng, nhằm hạn chế nguy cơ ảnh hưởng đến hạ tầng trọng yếu.
Ngày 13/10, Tổng Giám đốc Cơ quan An ninh nội địa Anh (MI5) Ken McCallum cảnh báo trí tuệ nhân tạo (AI) đang làm thay đổi các nguy cơ an ninh mà nước này phải đối mặt, trong đó có khả năng làm gia tăng mức độ nguy hiểm của các loại vũ khí sinh học hiện có hoặc tạo điều kiện phát triển những loại vũ khí mới.
Anthropic cảnh báo các mô hình trí tuệ nhân tạo (AI) cỡ nhỏ có thể sớm đạt khả năng tự sao chép và phát tán sang các thiết bị kết nối Internet. Kịch bản này làm dấy lên lo ngại về khả năng kiểm soát AI, đặc biệt nếu công nghệ bị lợi dụng để phát tán mã độc hoặc thực hiện các cuộc tấn công mạng.
Trước sự gia tăng của các thủ đoạn lừa đảo và tấn công mạng tinh vi bằng công nghệ trí tuệ nhân tạo (AI), Nam Phi đang tích cực thúc đẩy quản trị AI có trách nhiệm, tăng cường hợp tác quốc tế và nâng cao nhận thức cộng đồng để bảo vệ an toàn không gian mạng.
Lo ngại rủi ro các tác nhân trí tuệ nhân tạo (AI) tự ý xâm nhập dữ liệu công như sự cố tại Australia, Chính phủ Anh dự kiến siết chặt quy định an toàn AI và bắt buộc báo cáo các sự cố an ninh mạng liên quan.
Viện Công nghệ Thông tin và Truyền thông Quốc gia Nhật Bản (NICT) đã phát triển hệ thống WISDOM-AR nhằm đánh giá khả năng chống lại các thủ thuật đánh lừa của trí tuệ nhân tạo (AI) tạo sinh, qua đó phát hiện nguy cơ mô hình AI cung cấp thông tin nguy hiểm hoặc gây hại cho con người và xã hội.
Người dân Nhật Bản đang đổ xô xin cấp lại giấy phép lái xe sau vụ tấn công mạng nhằm vào dịch vụ chia sẻ xe Times Car, khiến dữ liệu của khoảng 6,6 triệu tài khoản bị ảnh hưởng, trong đó hình ảnh giấy tờ xác minh danh tính của hơn 1,6 triệu tài khoản được cho là đã bị rò rỉ.
Số vụ phát tán trái phép nội dung văn hóa Hàn Quốc (K-content) ở nước ngoài trong năm 2025 lên tới 493,6 triệu vụ, tăng 19,2% so với năm trước và cao nhất kể từ khi cơ quan chức năng bắt đầu thống kê vào năm 2022.
Bill Gates cảnh báo các cuộc tấn công mạng lợi dụng trí tuệ nhân tạo (AI) có thể gia tăng mạnh trong năm tới. Nhà lãnh đạo Microsoft kêu gọi thiết lập cơ chế giám sát độc lập và “phanh khẩn cấp” cho các mô hình AI tiên tiến nhằm ngăn chặn những rủi ro ngoài tầm kiểm soát.